フロー パフォーマンスの最適化
Tableau Prep Builder および Tableau Prep Conductor から最高のパフォーマンスを得るために、クエリを参照元データ ソースにプッシュダウンする方法を最適化して、不要なデータ処理を最小限に抑えるようにフローを構造化することができます。
クエリの最適化にパフォーマンス設定を使用する
Tableau Prep Builder および Tableau Server バージョン 2026.3 以降でサポートされています。
Tableau Prep には、クエリ最適化と照合順序の設定が含まれています。この設定は、フローの処理時にデータベースへ送信されるデータ量を最大化することで、ネイティブ データ コネクタ内で処理を維持して、Hyper エンジンへローカルに転送されるデータ量を削減するように設計されています。
フローのパフォーマンス設定を構成するには、次の手順を実行します。
-
Tableau Prep Builder で、最適化するフローを開きます。
-
ツールバーから、[ヘルプ] > [設定とパフォーマンス] > [パフォーマンス設定] をクリックします。
-
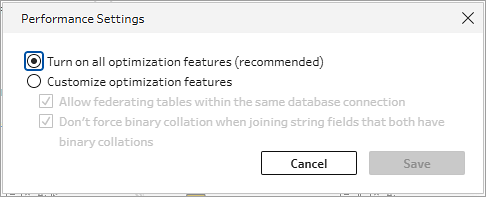
[パフォーマンス設定] ダイアログで、次のオプションを選択します。
-
[Turn on all optimization features (すべての最適化機能をオンにする) (推奨)]: 既定で有効になっています。このオプションでは、すべての推奨値が自動的に適用されます。
-
Customize optimization features (最適化機能をカスタマイズする): 個々の最適化動作を手動で調整するには、このオプションを選択します。
-
Allow federating tables within the same database connection (同じデータベース接続内でテーブルのフェデレーションを許可する): 接続の再利用を制御します。有効にすると、Tableau Prep は同じデータベース接続の複数のテーブルを参照するクエリをデータベースに送信しようとします。クエリをデータベースに送信すると、テーブルが Hyper にマテリアライズされるのを回避できます。
-
Don’t force binary collation when joining string fields that both have binary collations (両方にバイナリ照合順序がある文字列フィールドを結合する際にバイナリ照合順序を強制しない): 両側でバイナリ照合順序が共有されている場合、Tableau Prep で結合句が不必要にバイナリ照合順序にキャストされるのを防ぎます。ネイティブの照合順序を保持すると、ソース データベースのインデックスが維持され、Hyper へのデータの強制的なマテリアライズが回避されます。
-
-
パフォーマンス設定を調整するタイミング
-
複雑なクエリ: クエリが非常に複雑な場合 (たとえば、最終的なピボットの前に行数を大幅に増やす中間結合やピボット解除など)、ソース データベースに実行をプッシュすると、Hyper で実行するよりもパフォーマンスが低下する可能性があります。このような場合は、[Customize optimization features (最適化機能をカスタマイズする)] を選択し、[Allow federating tables within the same database connection (同じデータベース接続内でテーブルのフェデレーションを許可する)] をオフにします。
-
レガシー ドライバーと結合のエラー: フィールドの照合順序が実際に異なる場合に、古い ODBC ドライバーが誤ったバイナリ照合順序を報告すると、強制バイナリ照合順序がオフになっているときに結合操作が失敗する可能性があります。文字列フィールドで結合エラーが発生した場合は、設定をカスタマイズするか、データベース ODBC ドライバーを更新してください。
高速フロー処理のためのベスト プラクティス
クエリ パフォーマンス設定の構成に加えて、フローが効率的に実行されるように次のベスト プラクティスに従ってください。
入力ステップを早期に最適化する
-
列を早期に削除する: [入力] ステップで、未使用のフィールドの横にあるチェック ボックスを直接クリアして除外します。不要なフィールドを早期に削除すると、ダウンストリームで Tableau Prep がメモリと処理能力を消費するのを防ぐことができます。
-
行を早期にフィルターする: [クリーニング] ステップまで待つのではなく、[入力] ステップでフィルターを直接適用します。これにより、余分な行が処理パイプラインに入るのを防ぎます。
-
相対日付フィルターを使用する: 履歴データが不要な場合は、相対日付フィルター (「過去 12 か月」など) を入力テーブルに直接適用します。
作成中にデータ サンプリングを管理する
-
プレビュー行を制限する: 遅延を生じさせることなく、インタラクションの速度を維持するようにフローを設計する場合、[入力] ステップでデータ サンプリングを使用します。
-
サンプルの制限を把握する: 既定のサンプルの上限は 100 万行ですが、これは列数が増加するにつれて減少します。未使用のフィールドを削除すると、サンプル サイズをより大きな代表性の高いものに保つことができます。
インタラクティブな作成と更新頻度を最適化する
-
インタラクティブな更新を一時停止する: 大規模なフローに構造的な編集を行う際に、ツールバーの [一時停止] ボタンをクリックして、インタラクティブなデータ グリッドの更新を停止します。
-
増分更新を使用する: 出力で [増分更新] を構成すると、Tableau Prep では、データ セット全体を再読み込みするのではなく、スケジュールされた実行の際に新しい行または更新された行のみが処理されます。
高速出力形式を選択する
-
Hyper 抽出にエクスポートする: データをファイルに出力する場合は、.csv ではなく、Tableau Hyper (.hyper) 抽出形式を選択します。Hyper ファイルは、テキスト ファイルよりも指数関数的に高速に処理および書き込みを行います。